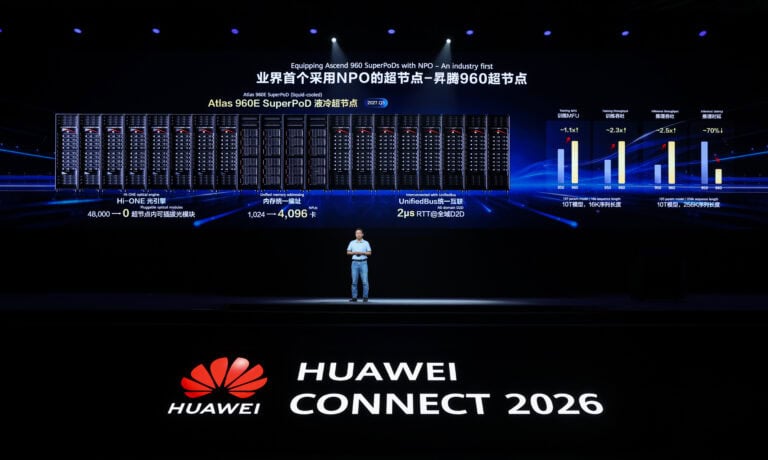
Huawei versnelt zijn Ascend-roadmap en presenteert de Atlas 960E SuperPoD. Het bedrijf prijst het als het eerste systeem op basis van near-packaged optics. De SuperCluster schaalt door tot een miljoen NPU’s.
David Wang, Deputy Chairman of the Board and Rotating Chairman, zet op de Huawei Connect 2026-conferentie in Shanghai de koers uiteen. De kern van het verhaal: AI-infrastructuur moet geen verzameling losse servers zijn, maar een sterk geïntegreerd systeem. Huawei bouwt die visie rond SuperPoDs en SuperClusters, met de eigen UnifiedBus-interconnect als bindmiddel.
De cijfers waarmee Wang zijn betoog onderbouwt, zijn niet bescheiden. Foundation-modellen naderen tien biljoen parameters en zouden in 2030 boven de honderd biljoen uitkomen. Alleen al in China worden dagelijks zo’n 500 biljoen inference-tokens verbrand. En on-device modellen voor smartphones groeiden van drie miljard parameters in 2024 naar dertig miljard nu.
Eén generatie per jaar
De SuperPoDs draaien op de Ascend, de NPU’s die Huawei zelf bouwt. “We ontwikkelen onze Ascend-chipserie door met een cyclus van één generatie per jaar”, aldus Wang. De Atlas 960E SuperPoD draait straks op de Ascend 960DT, die in het eerste kwartaal van 2027 verschijnt. Op de Atlas 960E SuperPoD moet er nog wat langer gewacht worden dan op de serverchip zelf, namelijk tot het derde kwartaal van volgend jaar.
De Ascend 960DT biedt tot 2 PFLOPs aan FP8-rekenkracht en 4 PFLOPs aan FP4-rekenkracht. Dat maakt de NPU’s optimaal voor zware AI-workloads. Ook beschikken de chips over maximaal 288 GB High Bandwidth Memory, dat draait op een snelheid van 9,6 TB/s. Dat is 2,4 keer sneller dan de vorige Ascend-generatie. De bandbreedte tussen de chips onderling bedraagt 2,2 TB/s per chip.
In 2028 en 2029 moeten ook respectievelijk de Ascend 970 en 980 volgen. Dankzij wat Huawei de Tau-scalingwet noemt, moeten de rekenspecificaties, geheugenbandbreedte, geheugencapaciteit en interconnect-bandbreedte fors meegroeien.
Waarom SuperPoDs?
In het SuperPoD-systeem zijn meerdere nodes via snelle interconnect-protocollen strak geïntegreerd, met unified memory addressing over fysieke nodes heen. Het geheel gedraagt zich als één logische computer.
Clusters van 100.000 NPU’s zijn de norm geworden voor het trainen van state-of-the-art modellen. Bij traditionele serverarchitecturen slokt de communicatie binnen het cluster ruim veertig procent van de totale trainingstijd op, wat de Model FLOPs Utilization stevig indamt. Simulaties van het Markov Lab van Huawei wijzen uit dat een cluster van 100.000 NPU’s opgebouwd uit SuperPoDs van 4.000 NPU’s een 2,75 keer hogere MFU haalt dan hetzelfde cluster op basis van servers met acht NPU’s.
Optica dichter tegen de chip aan
De interessantste hardwareaankondiging zit in de optiek. Huawei introduceert de High-density Optical-interconnect-Node Engine, kortweg Hi-ONE, gebaseerd op near-packaged optics (NPO). Eén engine haalt een transmissiecapaciteit van 7,2 Tbit/s. Huawei stelt dat het product het eerste NPO-onderdeel is dat klaar is voor massaproductie en het enige met een ingebouwde lichtbron.
NPO plaatst de optische engine dicht tegen de application-specific integrated circuit (ASIC) aan. Dat leidt tot lager energieverbruik, minder signaalverlies en betere koeling. Het kent tegelijkertijd modulariteit en onderhoudbaarheid.
Met Ascend 960-chips en Hi-ONE bouwt Huawei de Atlas 960E SuperPoD. Die schaalt tot 4.096 NPU’s, levert 8 EFLOPS aan FP8-rekenkracht en biedt tot een petabyte HBM-capaciteit. Door 5.500 Hi-ONE-units in te zetten, zijn de 48.000 800G optische modules die normaal nodig zouden zijn niet langer vereist. Dat scheelt meer dan 550 kilowatt aan verbruik. De storingsvrije bedrijfstijd verdubbelt, met een systeembeschikbaarheid van 99,8 procent.
TaiShan, OceanStor en een miljoen NPU’s
Naast de AI-kant vernieuwt Huawei ook de general-purpose TaiShan 950 SuperPoD. Die ondersteunt nu tot 4.096 nodes met een unified memory pool van maximaal 256 TB. Voor sandbox-intensieve workloads starten 100.000 sandboxes dertig keer sneller op dan bij traditionele servers, terwijl de dichtheid met een kwart toeneemt. Vectorzoekopdrachten over tien miljard vectoren van duizend dimensies gaan twee keer efficiënter.
Daarbij komt de OceanStor M900, een context memory storage-cluster op UnifiedBus. Het systeem levert multi-tier KV-caching voor agentic inference, met one-hop directe toegang en een KV-cache op petabyte-schaal voor de L3.5-laag. Door hybride media en een geoptimaliseerd retentie-algoritme rekt Huawei de lees- en schrijflevensduur van SSD’s zestienvoudig op.
Alles bij elkaar vormt dit de agentic SuperCluster. UnifiedBus voegt meerdere interconnect-protocollen samen tot één protocol, wat de overhead van protocolconversie terugdringt en peer-to-peer-verbindingen mogelijk maakt tussen Ascend SuperPoDs, Kunpeng SuperPoDs en KV-cacheclusters. Met een tweelaags Clos-architectuur met vier planes koppelt de SuperCluster tot 512.000 NPU’s. In combinatie met een multi-rail-topologie loopt dat op tot een miljoen NPU’s.
Ecosysteem en ontwikkelaars
Huawei deelt ook cijfers over de softwarezijde. Het Kunpeng-ecosysteem telt meer dan 4,16 miljoen ontwikkelaars en ruim 7.200 partners, met ondersteuning voor meer dan 560 open source-projecten. openEuler kwam boven de twintig miljoen installaties uit en heeft daarmee het grootste aandeel in de Chinese markt voor serverbesturingssystemen.
Voor Ascend draait het om CANN, de Compute Architecture for Neural Networks. Externe ontwikkelaars vormen nu 61 procent van alle CANN-ontwikkelaars, voor het eerst meer dan de interne groep. De community telt ruim 5.200 maandelijks actieve ontwikkelaars. Meer dan veertig modellen zijn native voorgetraind op Ascend en CANN. Ascend ondersteunt ruim negentig externe open source-projecten, waaronder PyTorch, Triton, vLLM en veRL, en is met steun van de Linux Foundation het eerste Chinese compute-platform dat officieel op de PyTorch-website staat.
Huawei maakt op Connect ook bekend de chipplanning van de Ascend-chips in de SuperPoD-systemen te versnellen. De Ascend 960DT wordt in het eerste kwartaal van 2027 beschikbaar, drie kwartalen vroeger dan de oorspronkelijke roadmap aangaf. De Ascend 960PR, die weer wat betere prestaties levert, volgt in het derde kwartaal van 2027, een kwartaal eerder.