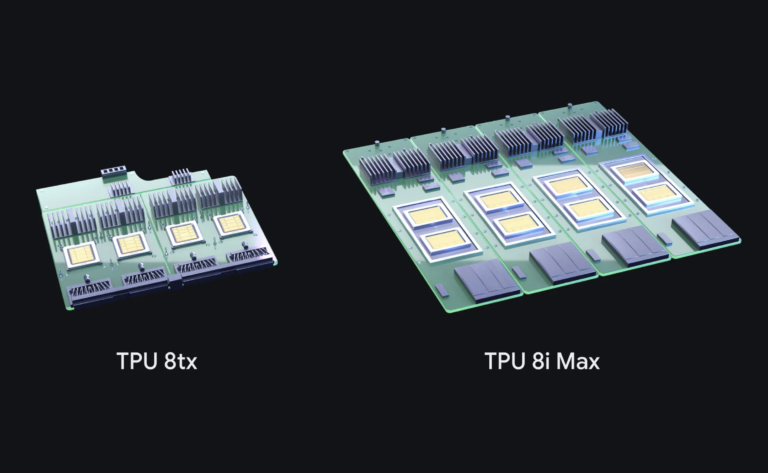
Nadat Google al specifieke Tensor Processing Units voor respectievelijk training en inferencing bouwde, heeft het nu nog dieper in de bottlenecks van agentic workloads gedoken. De 8tx biedt de veiligst mogelijke inferencing, terwijl 8i Max enorme context windows en hoge compute-dichtheid levert.
De 8t (training) en 8i (inferencing) waren in april van dit jaar een reuzensprong als het om efficiëntie en prestaties ging. Google blijft nu binnen dezelfde generatie, maar ziet ruimte voor verdere specialisatie. De 8tx is fundamenteel veiliger dankzij confidential computing. Ondanks de ’t’ is training niet de prioriteit, althans: niet op enorme schaal. Inferencing en compacte training-runs zijn de beste match voor deze chip waar het uiterst belangrijk is om eigen modellen privé te houden. Data blijft bij de 8tx versleuteld in het geheugen, het grootste gat in de securityketen voor training- en inferencingdata met AI. De 8tx wordt gekoppeld met vijfde generatie AMD EPYC CPU-hosts.
De 8tx gebruikt het Boardfly-netwerk dat Google voor de 8i ontwikkelde. Dat levert tot twee keer lagere latency op dan bij de TPU 8t. Organisaties kunnen daardoor op één systeem modellen fine-tunen met eigen data, grote modellen destilleren en agents trainen via reinforcement learning. Gevoelige data hoeft daarvoor niet tussen clusters te worden verplaatst.
8i Max: Google’s Blackwell?
Een belangrijk verschil tussen Nvidia’s Blackwell-generatie en haar voorgangers is dat er met de B200 en GB200 Superchip sprake was van een optelsom: twee stukken GPU-silicium op een extreem snelle manier via de substrate verbonden. Dit leverde feitelijk één chip op die groter was dan de productiemethoden rendabel toestaan. Google kiest voor hetzelfde pad met de 8i Max, de krachtigste TPU dankzij deze optelsom.
Google mikt op een hardnekkig probleem rondom AI-chips, namelijk de zogeheten ‘memory wall’. Hoe snel je GPU of TPU ook is, geheugenbandbreedte nekt de prestaties zodra bepaalde harde limieten worden bereikt. Denk aan een model dat niet in het geheugen van een enkele AI-chip past; de communicatie tussen processoren is vele malen langzamer dan de interactie binnen een enkele chip. De 8i Max verdubbelt de rekenkracht van de 8i, met tevens een verdubbeling van het uiterst snelle SRAM en de HBM-bandbreedte. Dit alles is tevens compacter dan gebruikelijke 8i-racks, met dubbel het silicium voor dezelfde rackruimte.
Software moet drempel verlagen
Naast de hardware pakt Google ook de software aan. Vorige maand maakte Google TorchTPU open source, waardoor PyTorch-code en Hugging Face-modellen native op TPU’s draaien. Onder meer TPU Sync is nieuw, dat een open-source laag biedt die HBM, host-DRAM, opslag en netwerk samenvoegt tot één geheugenhiërarchie. Volgens Google daalt de Time to First Token daarmee met meer dan 90 procent. Cloud Pathways en GKE dynamic slicing zijn nu algemeen beschikbaar. Met dynamic slicing starten jobs tot vijf keer sneller op.
Klanten kunnen TPU’s ook in hun eigen datacenters plaatsen. Daarnaast gaat Oracle Cloud Infrastructure vanaf 2027 TPU’s aanbieden. Volgens Business Insider heeft Anthropic daarnaast tot één miljoen TPU’s afgesproken en gebruikt Meta de chips voor model-serving.